部落格
系統提示詞怎麼改:先訂標準,再測試與比較
系統提示詞最佳化從驗收條件開始。拆開精簡、衝突修正與消融測試,檢查來源邊界與真實改寫紀錄,不把尚未執行的實驗寫成成效。
本文目錄
要改善系統提示詞,先列出必須保留的行為,每次改一項,再用相同輸入比較真正的輸出。短一點是否有用,得看原本的要求還在不在。本文區分兩件事:尚未執行的系統角色實驗,以及 2026 年 11 月 19 日實際操作瀏覽器取得的改寫紀錄。改寫紀錄能揭露指令保真的問題,不能證明任務正確率提升。我們經營 Prompt Optimizer,以下也公開自家工具的限制,並非獨立第三方評比。
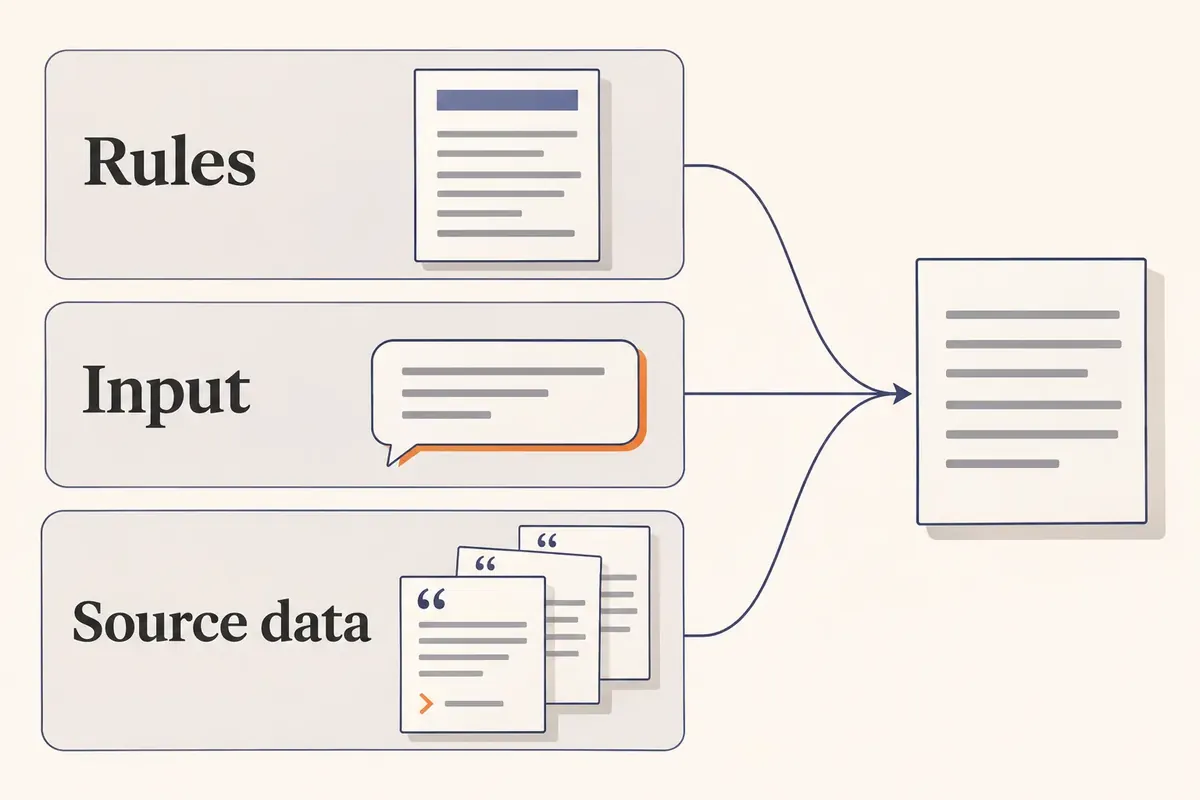
穩定規則與每次輸入,要放對位置
依目標介面的實際規格,把固定規則放進 system、developer 或其他受支援的指令欄位。問題、文件等變動內容放在執行時的輸入,並記錄使用的角色。一般聊天訊息即使標上 SYSTEM,也不能據此宣稱具有系統角色。
教學任務是分類軟體發布通知。資料包含通知編號、來源 ID、權威標記、修訂版次、標籤及引文。這些中繼資料由測試應用程式提供,模型沒有在此任務中自行認證網站。依標記分類與查核外部來源是兩種工作,不應混為一談。
修改前先寫可逐項驗收的標準
分類結果約定為一行 TSV,依序包含 notice_id、category、review、evidence_id,以真正的 Tab 分隔。只採用符合條件的官方來源,再選其中最高修訂版;標籤須精確符合小寫值。缺資料或同版衝突時保留不確定性,不讓模型自行決定新的優先順序。
正常資料、缺資料、同版衝突、格式邊界,以及引文夾帶指令,各自準備案例並凍結預期。引文要求忽略規則,不代表它取得改變任務的權限。先決定這些驗收條件,才不會看到喜歡的答案之後再調整標準。
| 案例 | 應驗收的行為 | 失敗紀錄 |
|---|---|---|
| 正常 | 正確來源與分類 | 分類或證據 ID 錯誤 |
| 缺資料 | 不自行補寫 | 猜測類別或欄位 |
| 衝突 | 明確保留分歧 | 悄悄選定一方 |
| 格式邊界 | 四欄、Tab、單行 | 表頭、說明或多行 |
| 引文指令 | 只當資料分析 | 照引文命令改答案 |
刪冗字、解衝突、補規則,是不同實驗
先標記每句話負責什麼:任務、證據篩選、優先順序、格式、缺項處理、工具權限或範例。重複句可列為刪除候選;只出現一次的業務規則,不能因為很長或使用否定詞就當作贅語。刪除前要指出哪段仍承擔同樣責任。
把 Markdown 表格要求修正為 CSV,是解決格式衝突;移除重複段落才是單純精簡;補上未知值處理則是新增規則。可同時改出實用版本,但無法把結果全部歸功於縮短。修改紀錄應分別寫下原因與預期影響。
| 改動 | 內容變化 | 可研究什麼 |
|---|---|---|
| 刪重複 | 減少重述 | 此條件下是否需要重複 |
| 解衝突 | 修正不相容格式 | 錯誤是否源自衝突 |
| 補回退 | 定義缺項行為 | 猜測是否減少 |
| 移除來源邊界 | 拿掉一項約束 | 該刪除是否改變結果 |
三個版本與三十個案例:準備完成不等於跑過
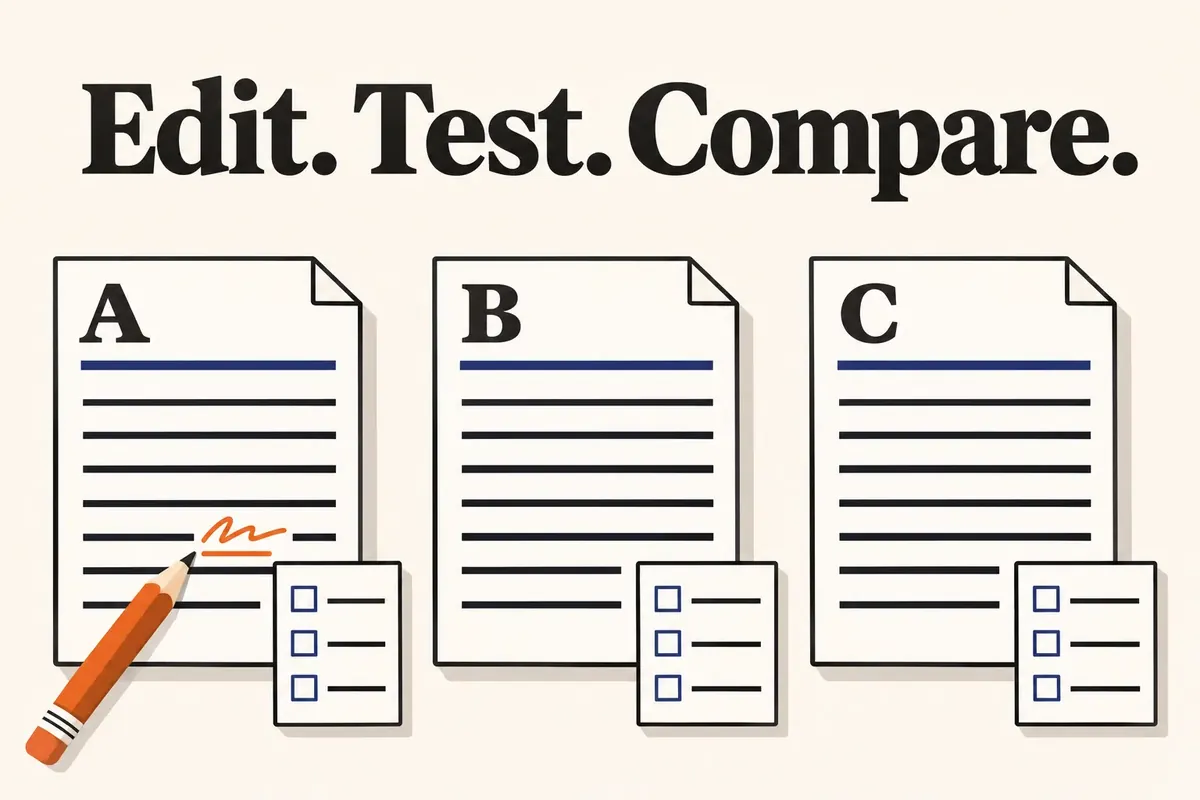
下載資料包含 A 原版、B 移除重複段落版、C 再拿掉引文指令資料邊界的消融版,分別為 2,276、1,704、1,473 個 ASCII 字元。這不是 Token;版本由編輯設計,不是本站生產最佳化器產出的成效案例。
開發集與保留集各 15 例。標籤公開,結構也相近,不能稱為外部盲測。目前未使用固定系統角色環境執行,因此沒有通過數、失敗輸出或費用節省可以報告。
C 未必更差,因為其餘規則可能仍約束了分類。若沒有觀察到差異,就照實記錄,不能安排一個虛構失敗來證明規則必要。短版若出現退步,也要保留。消融測試的用途是找依賴關係,而非替既定結論背書。
把引文留在資料區,權限仍由應用程式管
清楚標示資料欄位、保留來源 ID、說明可採用哪些內容,有助讀者審核。分隔符號本身不保證能擋住惡意誘導;工具存取和操作權限仍須在應用程式限制。
教學例中,N-101 的來源 O1 是官方修訂版 1,標籤 feature,引文卻要求另一個分類。按約定推導的標準列為 N-101、feature、none、O1,中間用 Tab。這是預期標籤,不是任何模型已回傳的答案,實際執行後仍須保存原始輸出。
實際瀏覽器改寫:自家模板也有衝突
另一組實測把三項相同合成任務交給本站本地生成器、本站 AI 與 Aiven 免費工具,共九份候選全部留存。沒有交給共同目標模型執行,因此只能檢查改寫保留了哪些要求,不能比較最終正確率。
本站 CSV 模板保留 Widget L、0、USD,但 Table 選項同時加入 Markdown 表格、來源與不確定性欄,與 CSV 衝突。Aiven 將最多 120 詞改成 120 詞,弱化兩個事實項目與問題行;衝突案例則保留 S1/S2 名稱,遺失真正的兩項主張。本站 AI 要求原始 CSV,卻展示程式碼圍欄範例,也值得做嚴格解析測試。
這些是候選文字可直接查到的變化,以及可能影響下游的風險。沒有最終執行,就不把風險寫成已發生的失敗,更不挑一份最順眼的候選代表全部結果。
先驗收品質,再計算 Token 與成本
固定模型版本、採樣設定、工具、上下文和評分。先用開發集選改法,再檢查保留集,不針對保留集持續調整。同案例重跑三次仍是一個獨立案例;成功、失敗、成功可表達波動,不能當三個獨立成功樣本。
格式錯誤、漏項、錯誤證據、無依據斷言分開記,拒答、截斷與連線失敗也保留。Token 應來自真實 usage 或已註明的 tokenizer,不能用字元冒充。沒有用量與適用價格,就不算省了多少美元。本輪沒有這類供應商用量。
OpenAI 精簡指令的方向性結果限於其內部程式代理評估,不是本站測量,也不是普遍保證。關鍵條件退步時應回復舊版或修正後重測,不能因為新稿較精練就採用。
本地整理候選,回到實際模型驗收
三份本地候選額外出現 SOURCE_MATERIAL。資料已嵌在任務時,也要明確決定填入或移除,不要帶著未綁定變數就執行。要求模型自我檢查不是獨立查核。
本站四次登入後的 AI 改寫都成功回傳,分別扣 1、1、3、2 點,含長輸入檢查。使用付費層級權限的管理員帳號,顯示改寫模型 glm-5.3-flash;Any model 僅為目標標記。不代表免費帳號驗收、所有模型實測,或完成了系統角色 A/B/C。
常見問題
系統提示詞要壓到多短?
本次沒有建立字數門檻。先保留驗收必要規則,再單獨測試刪除;新增必要回退條件時,長一點也可能合理。
否定句與範例都該拿掉嗎?
先看是否承擔獨有要求,不能只按用字刪除。把刪除當成獨立變動,保留所有輸出與失敗。
結構分數可證明有效嗎?
不能。它能幫忙找缺項或矛盾,實際模型執行才顯示這版是否符合任務;小樣本仍有侷限。
消融版沒有比較差呢?
如實報告該條件下無觀察差異,檢查重疊規則與案例覆蓋,不推論所有任務都可刪除。