提示詞質量指南
提示詞評估指南:建立測試集、評分標準與迴歸檢查
用代表性案例、可觀察標準和清晰的釋出決定,建立可重複的提示詞評估流程。

提示詞評估檢查什麼
提示詞評估,是在修改指令與釋出新版本之間補上的證據環節。用相同的代表性輸入執行基線和候選提示詞,檢查可觀察的要求,再記錄接受或拒絕的決定。真正有用的結果不是一個萬能分數,而是說明哪裡變好、哪裡退化、哪些地方仍需要人工判斷。
如果只想在呼叫模型前做一次結構初檢,可以使用提示詞評分工具。它檢查的是指令本身,不能替代用真實案例測試模型回答。
一條提示詞看起來更清楚,實際表現仍可能變差。更長的指令會增加 token 成本,新的格式規則可能破壞工具呼叫,過於自信的回答也可能掩蓋證據不足。評估讓這些取捨在擴大使用範圍前暴露出來。它與提示詞最佳化指南互補:最佳化提出針對性改動,評估判斷改動是否值得接受。
在實際工作流中,每次執行都要一起儲存模型、引數、檢索上下文和提示詞版本。否則一個分數無法復現,模型或資料變化造成的退化也可能被錯誤歸因於提示詞。
建立小型提示詞評估集
從提示詞在真實任務中必須做出的決定開始,建立一個緊湊的樣例集。三個差異明顯的案例,往往比二十個近似輸入更容易暴露問題。只有在某種失敗模式確實重要時才增加樣例,不要為了讓資料集看起來大而堆重複內容。
| 案例 | 它能發現什麼 | 客服分類示例 |
|---|---|---|
| 正常輸入 | 常規路徑是否穩定 | 資料完整的一條清晰請求 |
| 邊界輸入 | 規則在含糊邊緣是否仍然成立 | 一條訊息包含兩個請求,或同時符合兩個標籤 |
| 缺失或衝突輸入 | 資料不足時是否詢問而不是猜測 | 沒有賬戶 ID、日期互相矛盾或要求回答未提供的事實 |
保留原始輸入不變,儘量儲存“期望訊號”而不是一份唯一標準答案。分類任務可以記錄允許的標籤和必須出現的證據;寫作任務可以記錄事實、語氣和結構要求。這樣更容易遷移到不同模型,也不會過度依賴某一種參考措辭。
選擇可觀察的評分標準
評分標準要把“更好”變成別人可以檢查的要求。把硬性條件和偏好分開,並寫清什麼情況算失敗。提示詞評估工具可以自動整理表格,卻不能替你決定任務真正需要什麼。
| 標準 | 通過條件 | 常用檢查 |
|---|---|---|
| 任務結果 | 輸出完成了輸入要求的任務 | 分類、抽取、回答或程式碼行為符合案例目標 |
| 證據邊界 | 結論沒有超出提供的資料 | 有必要的原文證據,未知內容被明確標記 |
| 格式 | 輸出可以被下游使用或解析 | JSON 有效、欄位在允許範圍內、工具載荷外沒有額外文本 |
| 安全與不確定性 | 需要時詢問、拒答或升級人工處理 | 資料不足時 needs_human_review 為 true |
| 成本與延遲 | 改進符合執行預算 | token 估算和響應時間未超過限制 |
不要把五個獨立要求隱藏在一個 1 到 5 分裡。保留每個單項檢查,再給出總體摘要。即使候選版本平均分上升,只要 JSON 被破壞,也應該暫緩釋出。
比較基線與一次針對性改動
先固定執行條件,再修改提示詞。基線和候選版本使用完全相同的輸入、模型、引數、工具和上下文。一次只改變一個有意義的維度,結果才足以支援決定,而不是隻能講一個看似合理的故事。
基線:為每條客服訊息返回一個類別。
候選:返回類別、原文證據和 needs_human_review 布林值。

案例:清晰請求|一條訊息包含兩個請求|缺少賬戶資料
標準:類別正確 + 證據來自輸入 + JSON 有效 + 證據不足時標記人工複核- 儲存基線。編輯前記錄提示詞版本和每個案例的輸出。
- 寫出改動假設。例如:“要求提供證據後,資料缺失時的自信誤分類會減少。”
- 逐項評分。區分通過、失敗和不適用,並補充簡短失敗原因。
- 檢視取捨。除了主要任務分數,還要檢查成本、延遲、格式和邊界案例。
- 記錄釋出決定。接受、暫緩或拒絕候選版本,並把證據放在決定旁邊。
候選失敗時,先判斷原因,再決定是否增加指令。缺失的可能是上下文、工具許可權、模型變化、解析器問題,或評分標準本身要求了無法保證的結果。更多提示詞文字不能代替缺失資料。
謹慎使用模型評分器
確定性檢查通常應該先做,例如 JSON 解析、必填欄位、允許標籤、字串匹配、引用是否存在或數值閾值。大模型評分器適合補充語義相似度、幫助程度和語氣等難以用固定規則判斷的內容。
用已經由人工標註的案例校準評分器。給它範圍明確的標準,要求說明理由,並檢查與人工意見不一致的樣例。如果評分器獎勵了自信但沒有依據的回答,提示詞可能看起來變好了,風險卻更高。重要任務要保留人工複核,並在執行記錄中寫明評分模型和版本。
Langfuse 的評估文件展示了一種整理分數和資料集的方法,但使用平臺不是前提。OpenAI 的提示詞工程說明和準確度最佳化說明同樣強調明確標準、代表性資料和可重複檢查。
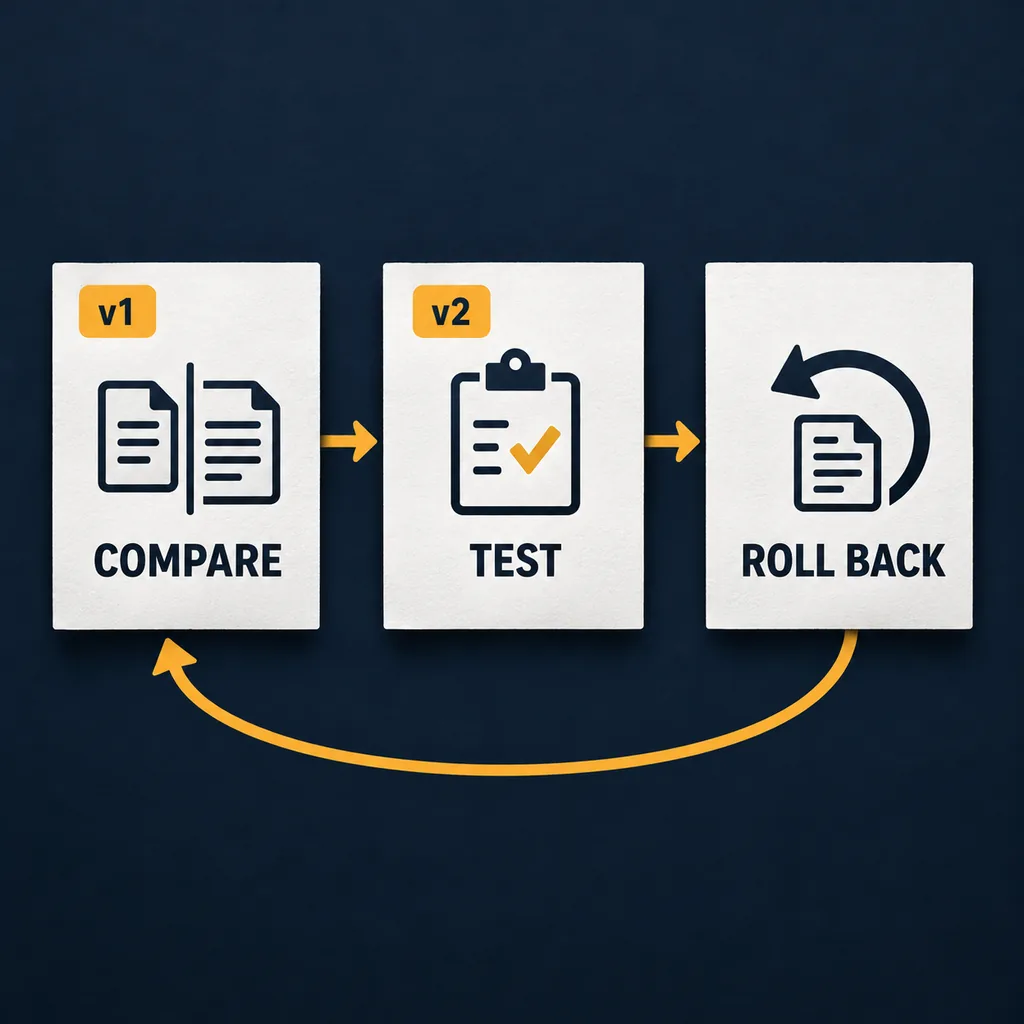
把提示詞評估變成可重複流程
當評估集和評分標準穩定後,每次有意義的修改都執行它們。讓候選版本與當前版本分開,並把結果連線到版本記錄。提示詞版本管理指南介紹了釋出和回滾的後半段流程。
- 準備:固定案例、評分標準、模型、引數和上下文快照。
- 執行:用相同輸入執行基線與候選,儲存輸出,不能覆蓋舊結果。
- 複核:檢視失敗項、評分器分歧、成本、延遲和邊界行為。
- 決定:標記接受、暫緩或拒絕,並記錄評審者和簡短原因。
- 重查:模型、檢索資料、工具或重要資料集變化後重新執行。
這個流程可以先放在表格或程式碼倉庫裡。當版本、模型、資料集或評審者增多,手工比較變得不可靠時,再考慮專門的提示詞評估工具。工具的作用是讓證據更容易找到,而不是把評分標準隱藏在一個總分後面。
常見誤區與限制
- 只測順利案例。加入含糊、缺資料和互相沖突的輸入。
- 同時改很多變數。把模型、上下文、工具和提示詞變化分開記錄。
- 把樣例數量當作證據。更多樣例無法修復有偏或不具代表性的評估集。
- 只相信總分。安全或格式檢查失敗時,即使平均分上升也要保留警示。
- 把模型評分器當成客觀裁判。檢查它的校準、漂移和與人工意見的分歧。
- 承諾絕對穩定。評估只對定義好的樣例和條件提供證據,不能保證未來每次輸出。
小結:評估決定,而不只是評估措辭
保留少量但差異明顯的評估集,定義可觀察的評分標準,用相同條件比較基線和一次針對性改動,並記錄候選版本被接受或拒絕的原因。先做確定性檢查,再加入模型評分器;重要案例保留人工複核,並把每次結果連線到提示詞版本。這樣,提示詞評估就從模糊分數變成了可重複的質量決定。
提示詞評估常見問題
什麼是提示詞評估?
提示詞評估,是用有代表性的輸入和明確標準,反覆檢查一條指令是否完成任務、哪裡會失敗,以及修改後的版本是否值得釋出。它不是給提示詞打一個神秘分數,而是為接受或拒絕改動提供證據。
評估一條提示詞需要多少個樣例?
可以先從 3 到 10 個樣例開始,至少覆蓋正常輸入、邊界情況,以及資料缺失或互相沖突的輸入。少量但差異明顯的樣例通常比很多近似案例更有資訊量,但它不能證明未來所有輸入都不會失敗。
提示詞評估的評分標準應該包括什麼?
選擇可觀察的要求,例如必填欄位、事實依據、允許的分類、有效 JSON、語氣、拒答行為、延遲或成本。把通過條件寫清楚,讓不同評審者不需要憑感覺也能得到接近的判斷。
提示詞評估工具一定比表格好嗎?
不一定。樣例較少時,表格或程式碼倉庫只要能同時儲存提示詞版本、輸入、標準、輸出和決定,就足夠開始。執行次數、模型、資料集和評審者變多後,提示詞評估工具才更能減少手工追蹤。
可以只用大模型評分器來評估提示詞嗎?
大模型評分器可以輔助語義和風格檢查,但它本身也會出錯。重要任務應同時使用確定性檢查、清晰評分標準、校準樣例和人工複核,不要把一個模型的分數當作唯一證據。
參考資料
- OpenAI:提示詞工程——任務要求、上下文、示例和模型差異。
- OpenAI:最佳化 LLM 準確度——用評估定位並改進應用質量。
- Langfuse:評估——資料集、分數和評估器工作流示例。